从真实行为到通用技能

以三维视觉与类脑科学为根基,把真实世界的行为、交互与操作,转化为机器可学习、可执行的数据与技能——研究与产品跑在同一条链路上。

查看代表性成果 ↓
SEC / 01 · RESEARCH LINESACTIVE — 03 UNITS

人体行为数据的规模化生产

把实验室动捕换成「视频进、数据出」的全自动流水线:从单目到多镜头、从身体姿态到手指接触与面部表情,输出带语义标签的全身三维动作数据——UNIData 百万小时级数据资产的学术底座。

具身感知与操作泛化

从「看懂物体」到「抓得住物体」:双目立体视觉一次完成类别级物体检测、位姿估计与三维重建,冻结通用视觉语言模型的感知层、专注操作决策——让机器人在没见过的物体与场景里也能一次成功。

数据引擎与跨本体技能迁移

真人示范即数据源:手物交互视频经物理校正与跨本体重定向,直接生成机械臂、灵巧手与人形机器人可执行的轨迹,把「一个人的动作」变成「所有本体的技能」。

SEC / 02 · PUBLICATION LEDGERVERIFIED — 06 ENTRIES

01人体行为数据的规模化生产

03 PAPERS
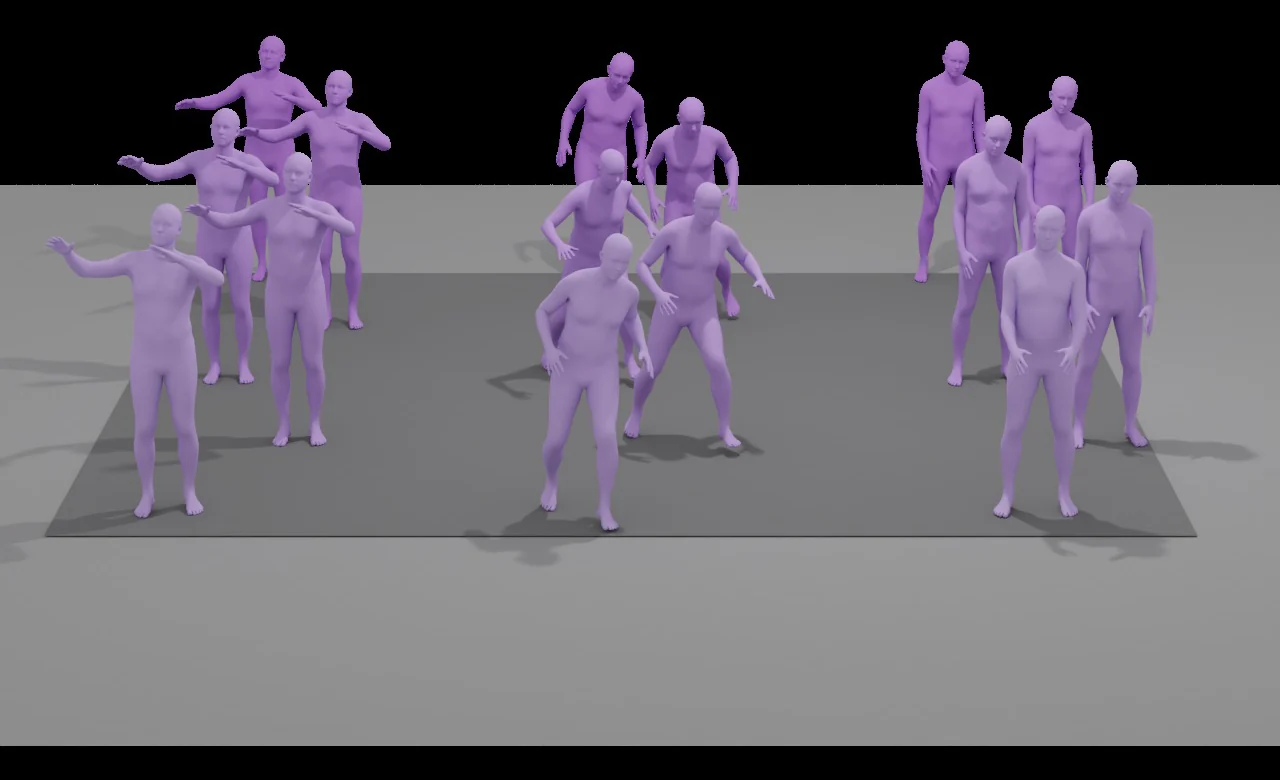
Motion-XNeurIPS 2023
Motion-X 论文配图

Motion-X: A Large-scale 3D Expressive Whole-body Human Motion Dataset

15.6M 帧全身三维姿态标注、81.1K 段动作序列;配套「视频 → 动作 + 文本」全自动标注流水线,把动捕从实验室推进到海量真实场景。
Motion-X++预印本 · 2025
Motion-X++ 论文配图

Motion-X++: A Large-Scale Multimodal 3D Whole-body Human Motion Dataset

规模再上台阶:19.5M 帧姿态、120.5K 段序列,并首次并入 80.8K 段 RGB 视频与 45.3K 段音频,打通音频驱动动作生成。
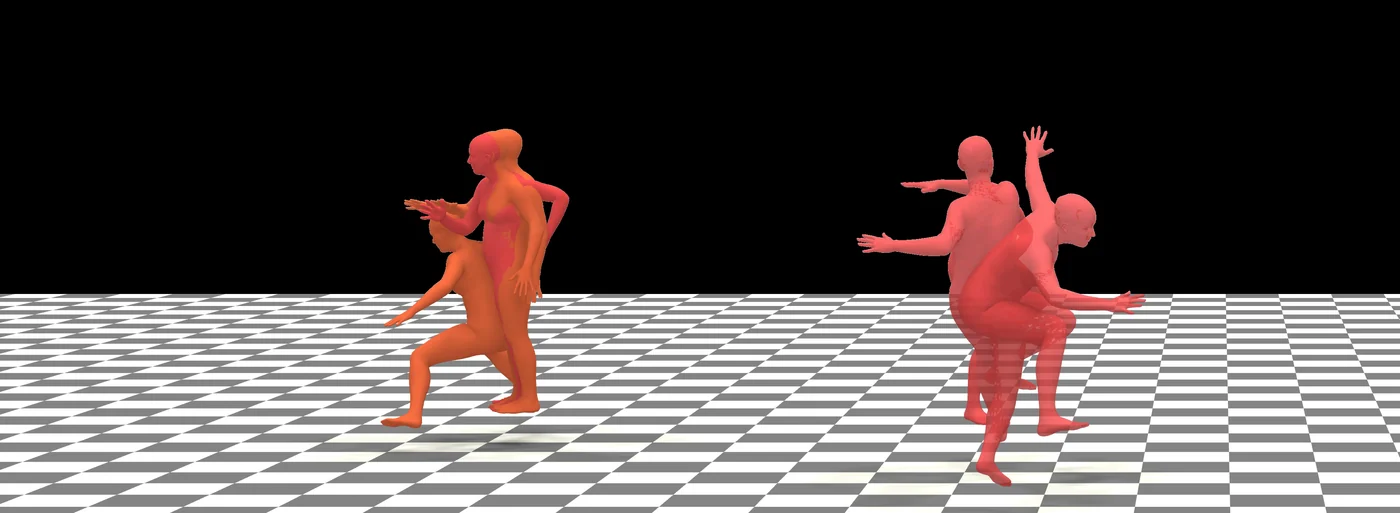
HumanMMCVPR 2025
HumanMM 论文配图

HumanMM: Global Human Motion Recovery from Multi-shot Videos

从多镜头剪辑的野外视频恢复世界坐标系连续动作:镜头切换检测 + 跨镜头对齐 + 防滑步积分,让剪辑过的素材也能产出长序列动作数据。
MOTION RECOVERYarXiv:2503.07597 ↗

02具身感知与操作泛化

02 PAPERS
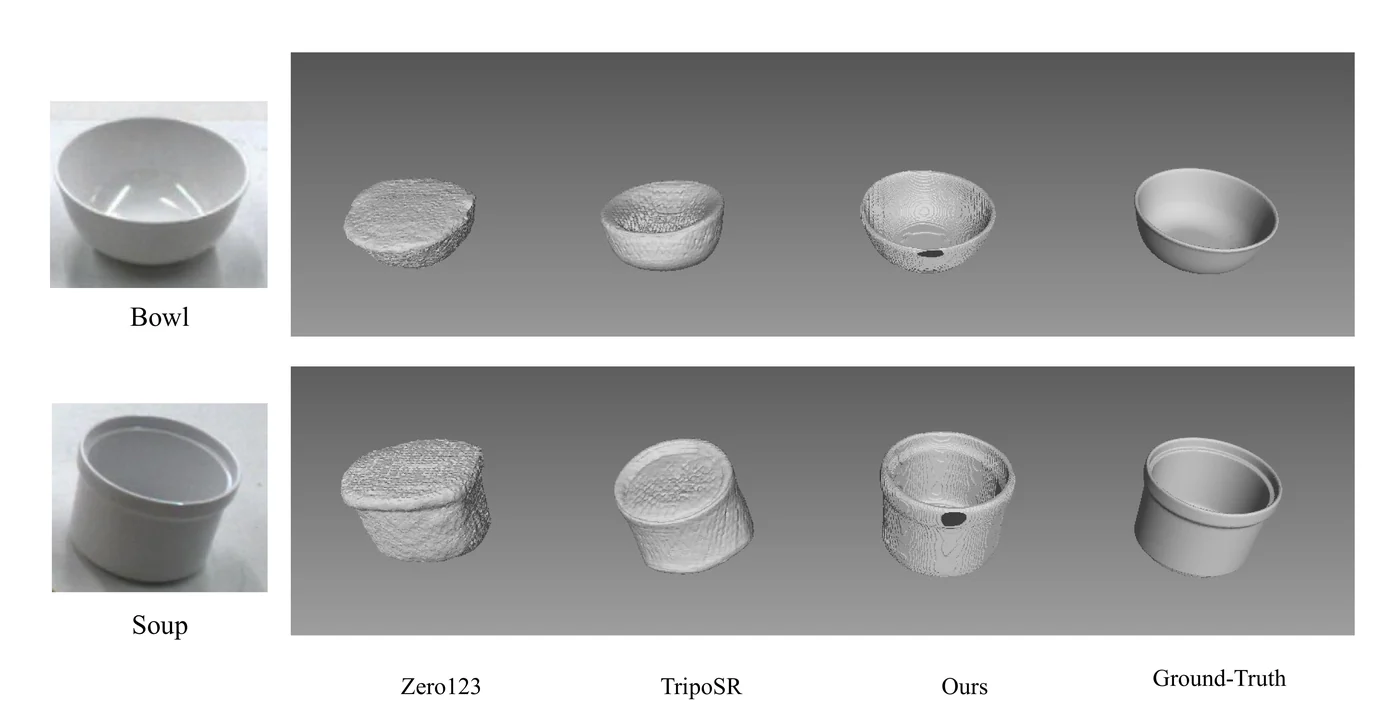
CODERS预印本 · 2024
CODERS 论文配图

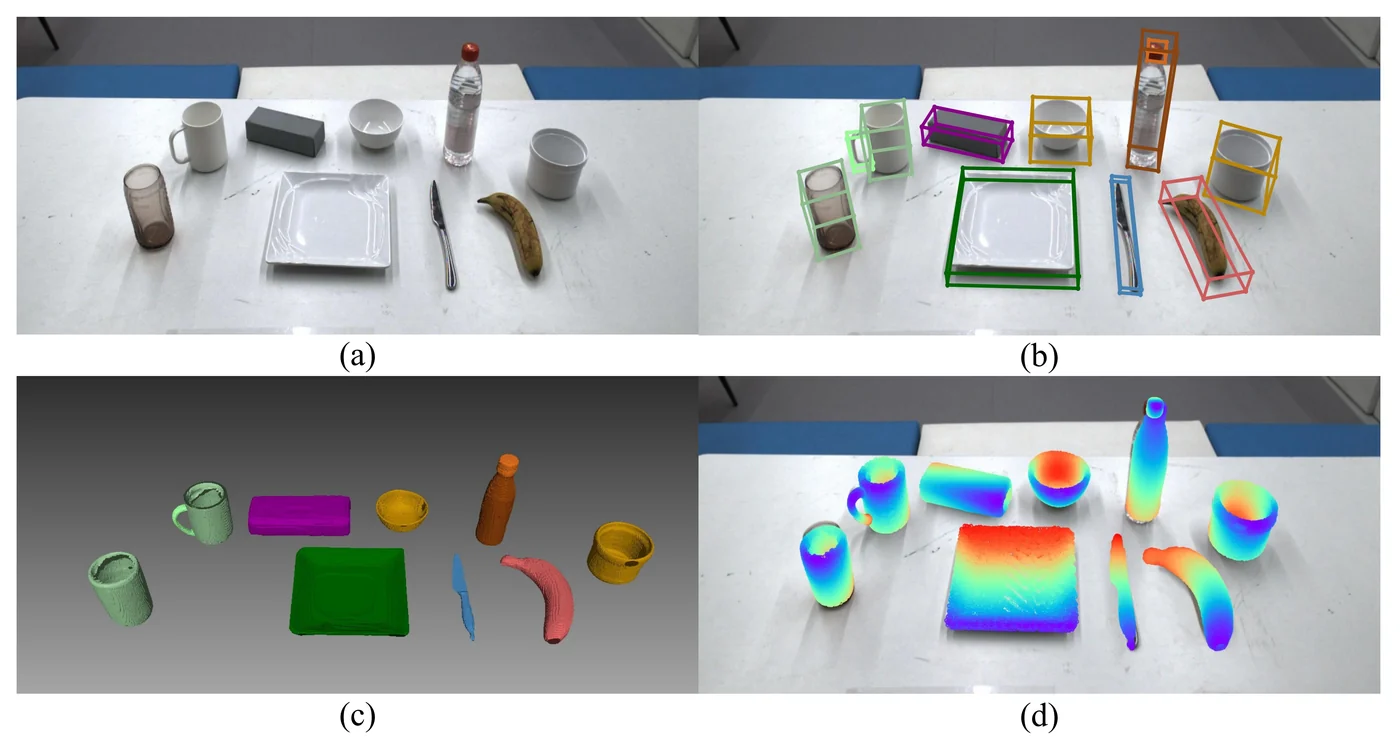
Category-level Object Detection, Pose Estimation and Reconstruction from Stereo Images

双目立体一阶段同时完成类别级检测、位姿估计与三维重建(含透明、高光等难材质);公开 TOD 数据集领先,仿真训练可迁移真机抓取。
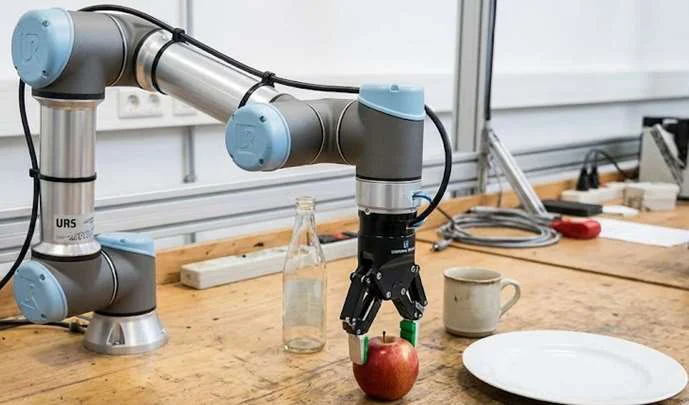
M²-VLAIROS 2026
M²-VLA 论文配图

M²-VLA: Boosting Vision-Language Models for Generalizable Manipulation via Layer Mixture and Meta-Skills

不走端到端微调:冻结 VLM 通用感知,以分层混合(MoL)抽取任务关键特征 + 元技能模块承担轨迹学习,兼顾零样本泛化与操作精度。
03数据引擎与跨本体技能迁移

01 PAPER
RoboWheel预印本 · 2025
RoboWheel 论文配图

RoboWheel: A Data Engine from Real-World Human Demonstrations for Cross-Embodiment Robotic Learning

手物交互视频 → 高精度重建 + 强化学习物理校正 → 跨本体重定向 → Isaac Sim 域随机化增强;首次定量证明 HOI 可作为机器人学习监督,效果与遥操作相当。

CERT / 04 · CREDENTIALSVERIFIED — 05 ITEMS
二十余年类脑科学技术积累
三年AGI 领域市场探索
NVIDIAInception 会员企业
107 项顶会顶刊成果
百万小时级真实作业数据集(UNIData)

研究开放合作

联合课题、数据共建与工程落地——面向研究者与产业伙伴持续开放。

SYS / ACTIONREV 2026.08