Video 第一视角视频
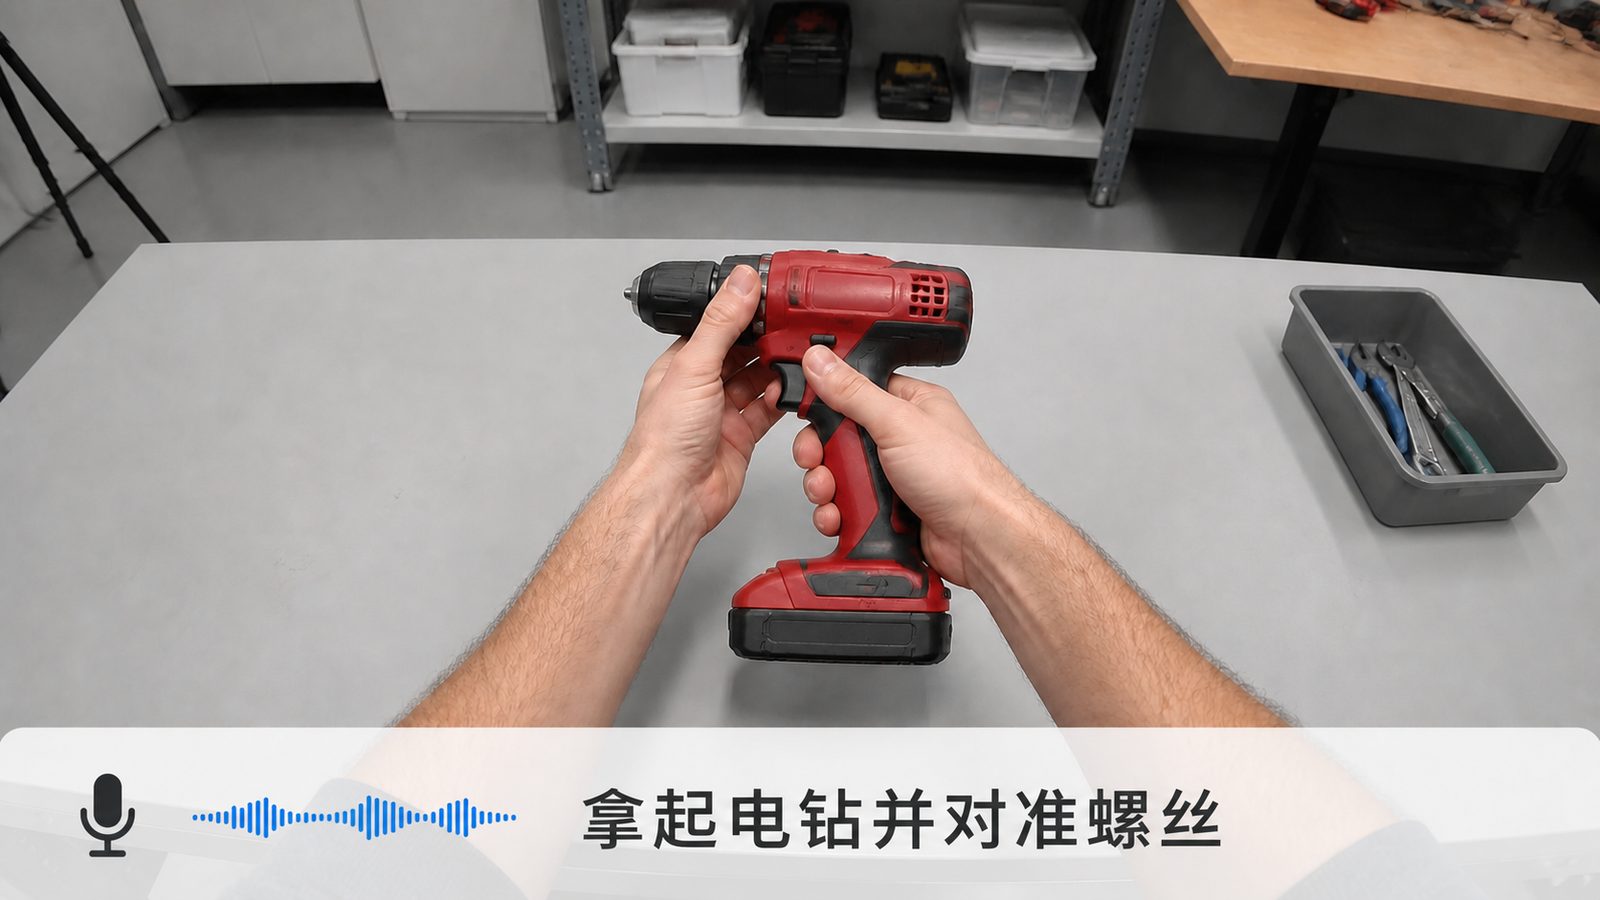
Egocentric RGBepisode 的原始观测和统一时间轴,所有模态对齐于此。
- RGB 视频、帧率、分辨率、逐帧或可恢复时间戳
- 相机内参、设备和编码信息
- 可选:Depth、双目/多目、音频、IMU、眼动
- 推荐标记:遮挡、模糊、掉帧、过曝、手出画、隐私区间
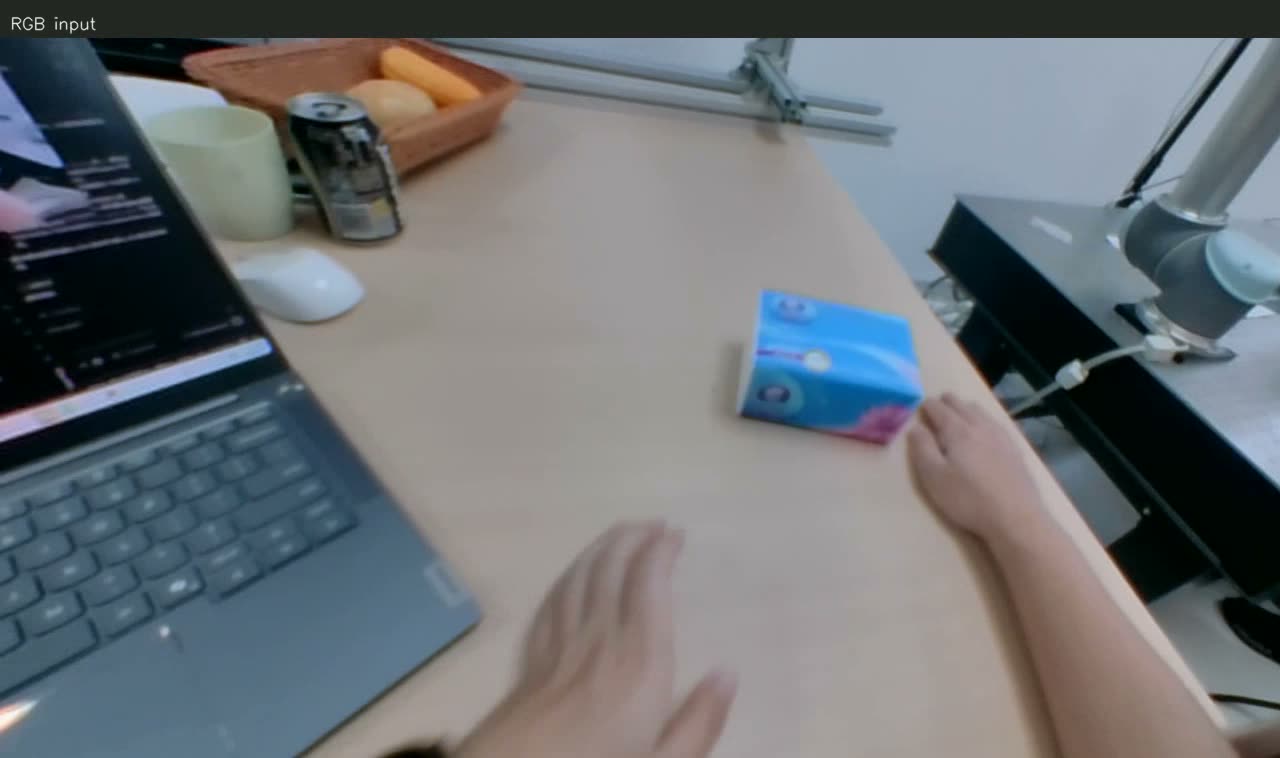
八种模态对齐到同一条时间轴——统一 episode、时间戳与坐标系。
episode 的原始观测和统一时间轴,所有模态对齐于此。
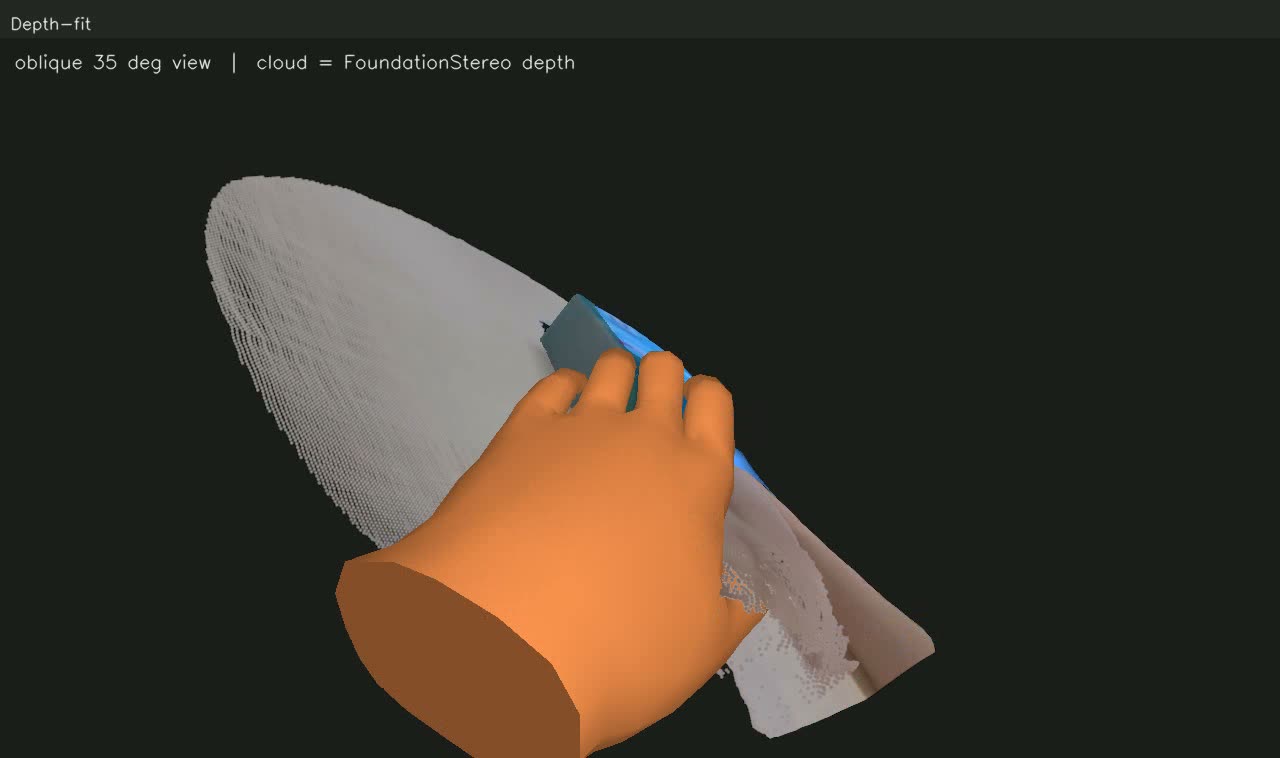
DETAIL ↓为每帧观测补充像素级距离,恢复操作场景三维结构与手物空间关系。
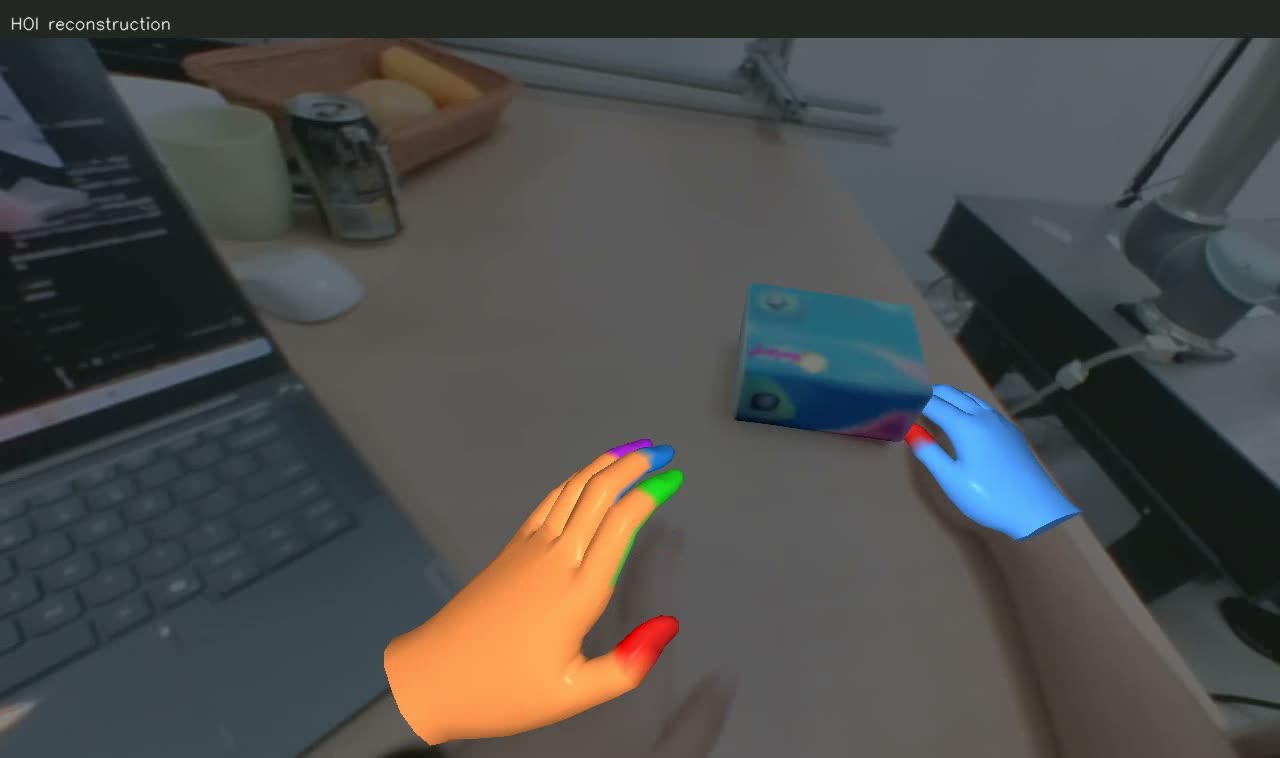
DETAIL ↓可参数化的三维手模型:紧凑形状与姿态参数生成手部 mesh 与关节,左右手分别记录。
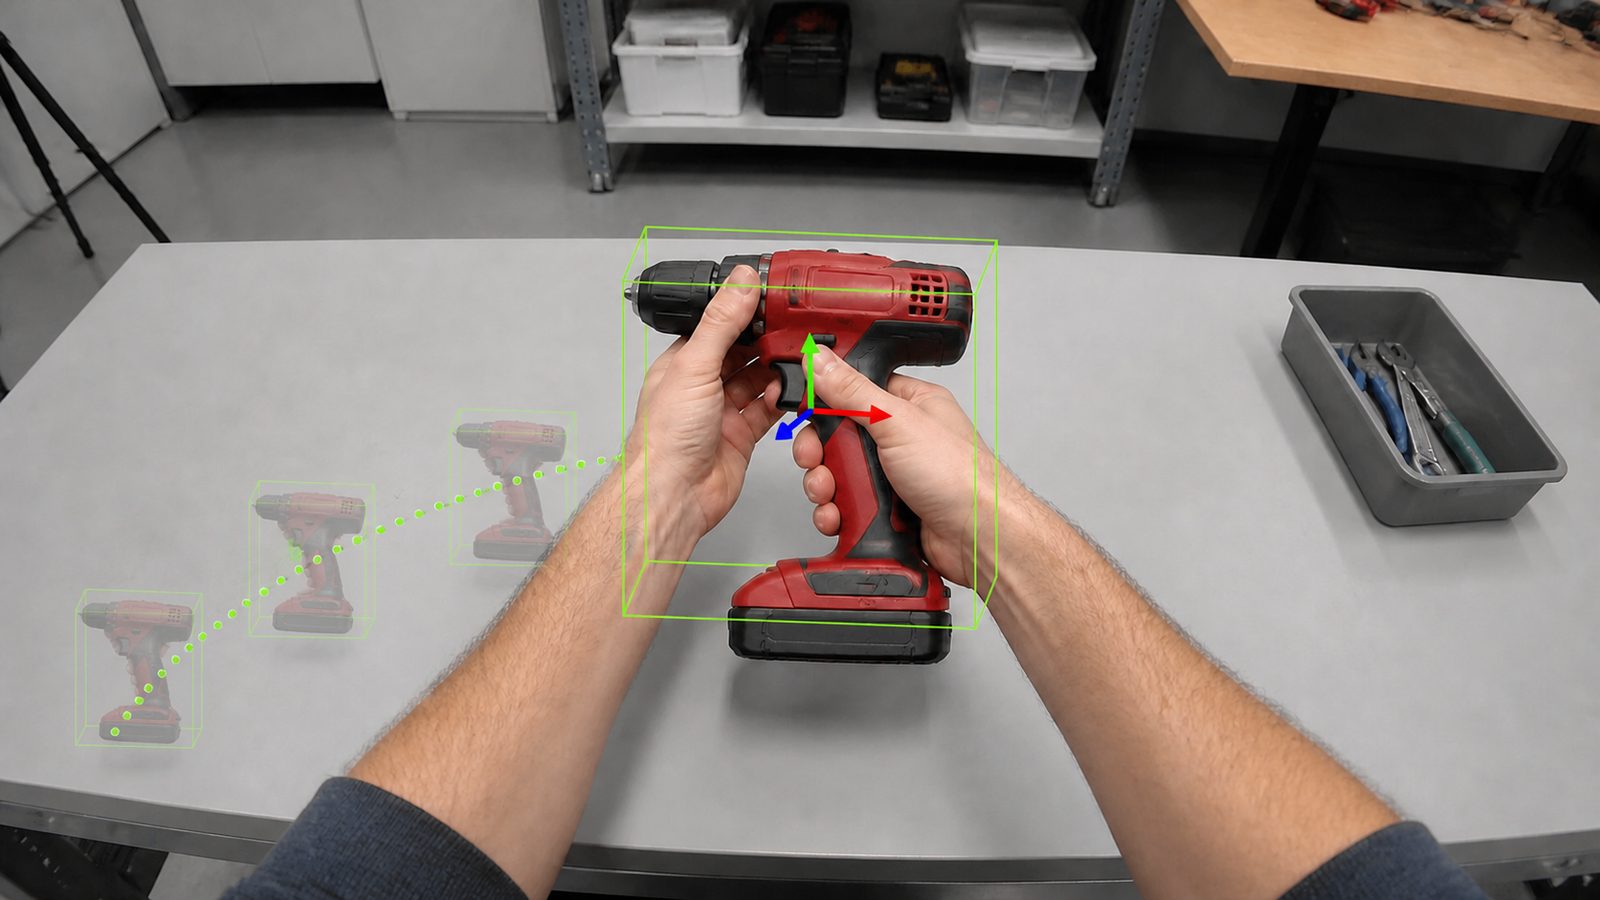
DETAIL ↓被操作对象随时间变化的空间状态;刚体用 6DoF,可动对象加关节状态。
DETAIL ↓头戴相机在世界坐标中的 SE(3) 位姿(VIO/SLAM/动捕/多传感器融合),三维时空对齐的关键模态。
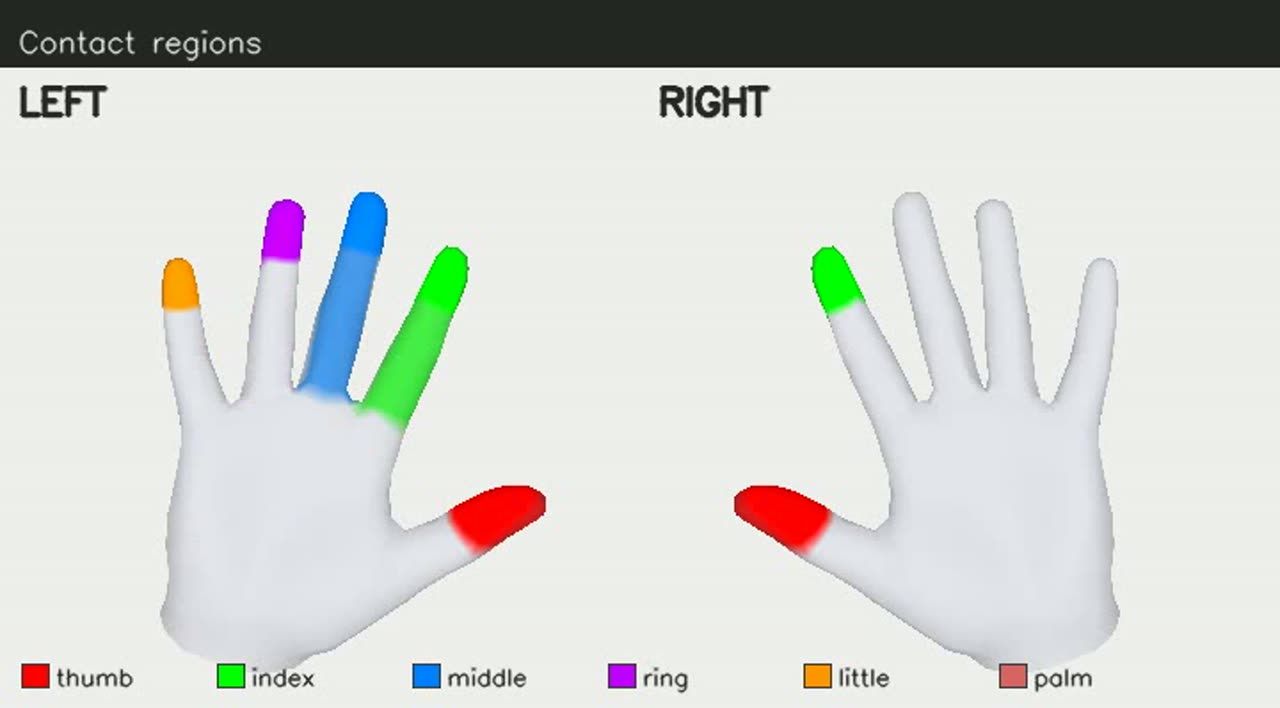
DETAIL ↓何时接触、哪根手指、接触在哪里、持续多久——粒度按成本与任务分级。
DETAIL ↓把连续操作转成可供检索、训练和规划使用的语义层:任务—步骤—原子动作三级结构。
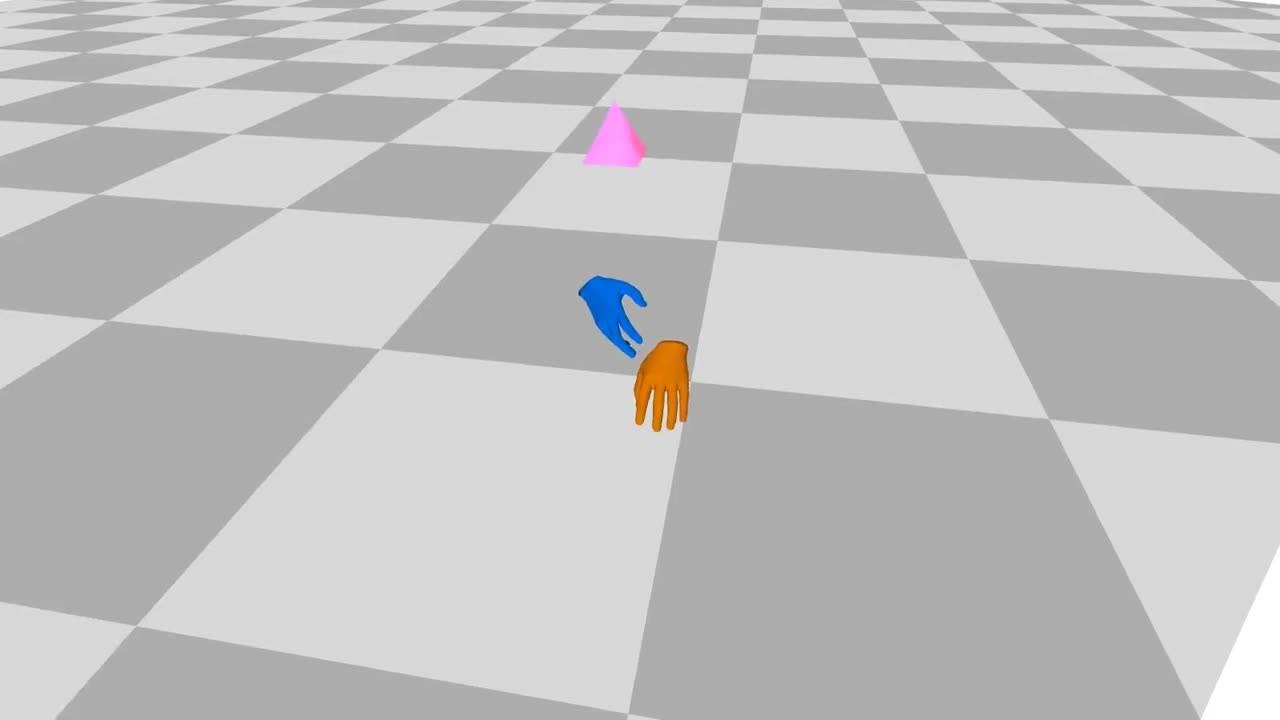
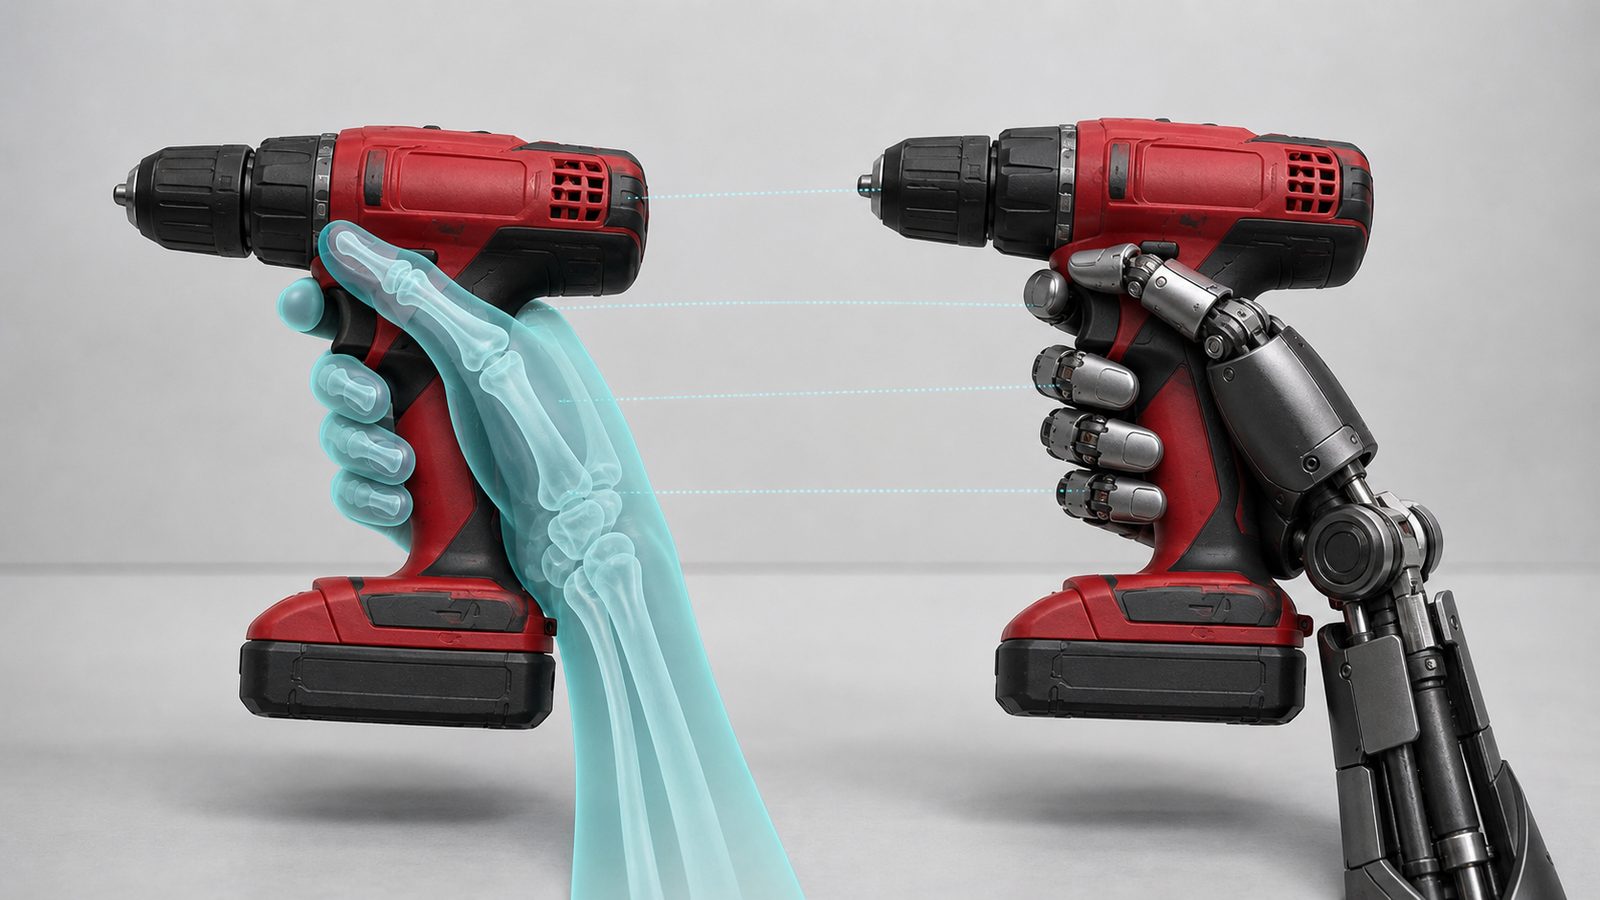
DETAIL ↓把人手动作映射到目标机器人手的关节与腕部控制空间——受约束优化问题,不是简单复制关节角。
DETAIL ↓episode 的原始观测和统一时间轴,所有模态对齐于此。

为每帧观测补充像素级距离,恢复操作场景三维结构与手物空间关系。

可参数化的三维手模型:紧凑形状与姿态参数生成手部 mesh 与关节,左右手分别记录。

被操作对象随时间变化的空间状态;刚体用 6DoF,可动对象加关节状态。

头戴相机在世界坐标中的 SE(3) 位姿(VIO/SLAM/动捕/多传感器融合),三维时空对齐的关键模态。

何时接触、哪根手指、接触在哪里、持续多久——粒度按成本与任务分级。

把连续操作转成可供检索、训练和规划使用的语义层:任务—步骤—原子动作三级结构。

把人手动作映射到目标机器人手的关节与腕部控制空间——受约束优化问题,不是简单复制关节角。

自研头戴设备以第一视角记录真实操作,采集时即保留后续多模态处理的基础信息:原始视频流、帧时间戳、相机参数、设备状态与任务配置;三维项目在采集前明确深度、IMU 与标定配置。
统一入库与资产登记(批次/设备/任务/场景/版本),基础质量清洗剔除模糊、过曝、掉帧与手出画片段,隐私合规处理,再把长流拆成语义边界清晰的 episode / step 训练单元。
把原始观测加工成结构化多模态监督信号:视频与深度对齐、相机轨迹、MANO 手部、物体 6DoF、接触状态、语言对齐、灵巧手重定向——所有输出挂接统一 episode / 时间戳 / 坐标系与 schema 版本。
四级过滤:基础可用性 → 模态内部质量(重投影误差/轨迹连续性/跟踪率…)→ 跨模态一致性 → 任务级可训练性;未达标数据进入返修、剔除或重采,不计入有效交付。
通过评测的数据打包为标准化资产:原始数据 + 训练友好版本 + 多模态标注 + schema/版本 + 质量报告。可交付、可追溯、可复用、可验收——交付量按通过评测的资产计算,而非原始采集时长。
通过评测才计入交付资产——返修 / 剔除 / 重采不计入有效交付量 · 可交付 / 可追溯 / 可复用 / 可验收
推荐产品形态,不限制实际选配
| 组合包 | 包含模态 | 适合任务 |
|---|---|---|
| 基础视觉包 | Video | 视频预训练 · 动作识别 · 人工标注底片 |
| 视频语言包 | Video + Language | 视频语言模型 · 检索 · 步骤理解 · VLA 预训练 |
| 手部动作包主推 | Video + MANO | 3D 手部重建 · 手势与抓取姿态学习 |
| 三维交互包 | Video + MANO + Object + Camera | 世界坐标下的手物联合跟踪和操作重建 |
| 接触操作包 | Video + MANO + Object + Camera + Contact | 抓取 · 接触预测 · 物理一致性 · 操作阶段识别 |
| 语言操作包 | Video + Object + Contact + Language | 对象中心的 VLA · 任务规划 · 动作结果理解 |
| 灵巧手示范包 | MANO + Object + Camera + Contact + Retarget | 遥操作回放 · 模仿学习 · 行为克隆 · 策略初始化 |
| 全模态包 | 全部模态 | 端到端具身模型 · 跨模态研究 · 完整评测 |